SPSSPRO,让数据分析更简单,问卷调查类数据分析不再愁 产品介绍 帮助中心 客户端
微信登录
  • 产品简介
  • 我的数据
  • PRO绘图
  • 数据处理
  • 描述性分析
  • 问卷分析
  • 综合评价
  • 差异性分析
  • 相关性分析
  • 预测模型
  • 统计建模
  • 计量经济模型
  • 医学统计模型
  • 机器学习分类
  • 机器学习回归
  • 规划求解
  • 研究模型
  • 信号分析
  • 自定义算法
  • 过程能力分析
  • 控制图
  • 测量系统分析
  • 可靠性生存分析
  • 全部分类
  • 全部标签
  • 文章归档
  • 产品简介
  • 我的数据
  • PRO绘图
  • 数据处理
  • 描述性分析
  • 问卷分析
  • 综合评价
  • 差异性分析
  • 相关性分析
  • 预测模型
  • 统计建模
  • 计量经济模型
  • 医学统计模型
  • 机器学习分类
  • 机器学习回归
  • 规划求解
  • 研究模型
  • 信号分析
  • 自定义算法
  • 过程能力分析
  • 控制图
  • 测量系统分析
  • 可靠性生存分析
  • 全部分类
  • 全部标签
  • 文章归档
  • 产品简介

  • 我的数据

  • PRO绘图

  • 数据处理

  • 数据分析

    • 描述性分析

    • 问卷分析

    • 综合评价

    • 差异性分析

    • 相关性分析

    • 预测模型

    • 统计建模

    • 计量经济模型

    • 医学统计模型

    • 机器学习分类

    • 机器学习回归

    • 规划求解

    • 研究模型

    • 信号分析

    • 自定义算法

    • 过程能力分析

    • 控制图

      • I-MR控制图
      • Z-MR控制图
      • P(NP)控制图
      • U(C)控制图
      • Xbar-R控制图
      • Xbar-S控制图
      • I-MR-R(S)控制图
      • 移动控制平均图
      • EWMA控制图
      • 累计和控制图
        • 1、作用
        • 2、输入输出描述
        • 3、案例示例
        • 4、案例数据
        • 5、案例操作
        • 6、输出结果分析
        • 7、注意事项
        • 8、模型理论
        • 9、参考文献
      • T²广义方差控制图
      • 多变量EWMA控制图
      • G控制图
      • T控制图
    • 测量系统分析

    • 可靠性生存分析

累计和控制图

发布:2025-08-29  | 最近更新:2026-09-24  | 责任主体:SPSSPRO

开始分析 下载案例数据

# 1、作用

累积和控制图通过累积观测值(观测值可以是单个测量值,也可以是子组均值)与目标值之间的差异来检测过程中的小偏移。由于 CUSUM 控制图是累积的,因此即使是过程均值中的微小波动也会导致累积偏差值的稳定增加(或降低)。累积和控制图能够比传统控制图更早地检测到过程中的变化,提高过程控制的灵敏度和效率。

# 2、输入输出描述

输入:1个定量变量或1个定量变量与定类变量的组合
输出:累积和控制图

# 3、案例示例

案例:一家离心机转子制造商想监视一周内生产的所有转子的直径与目标直径的偏差。直径与目标值必须非常接近,因为即使很小的偏差都会导致问题的出现。通过累积和控制图方法检查过程中是否存在失控点。

# 4、案例数据
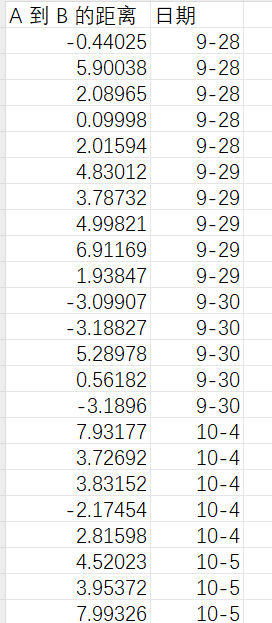
累计和控制图案例数据
案例数据

# 5、案例操作

新建分析并上传数据

Step1:新建分析;

Step2:上传数据;

Step3:选择对应数据打开后进行预览,确认无误后点击开始分析;
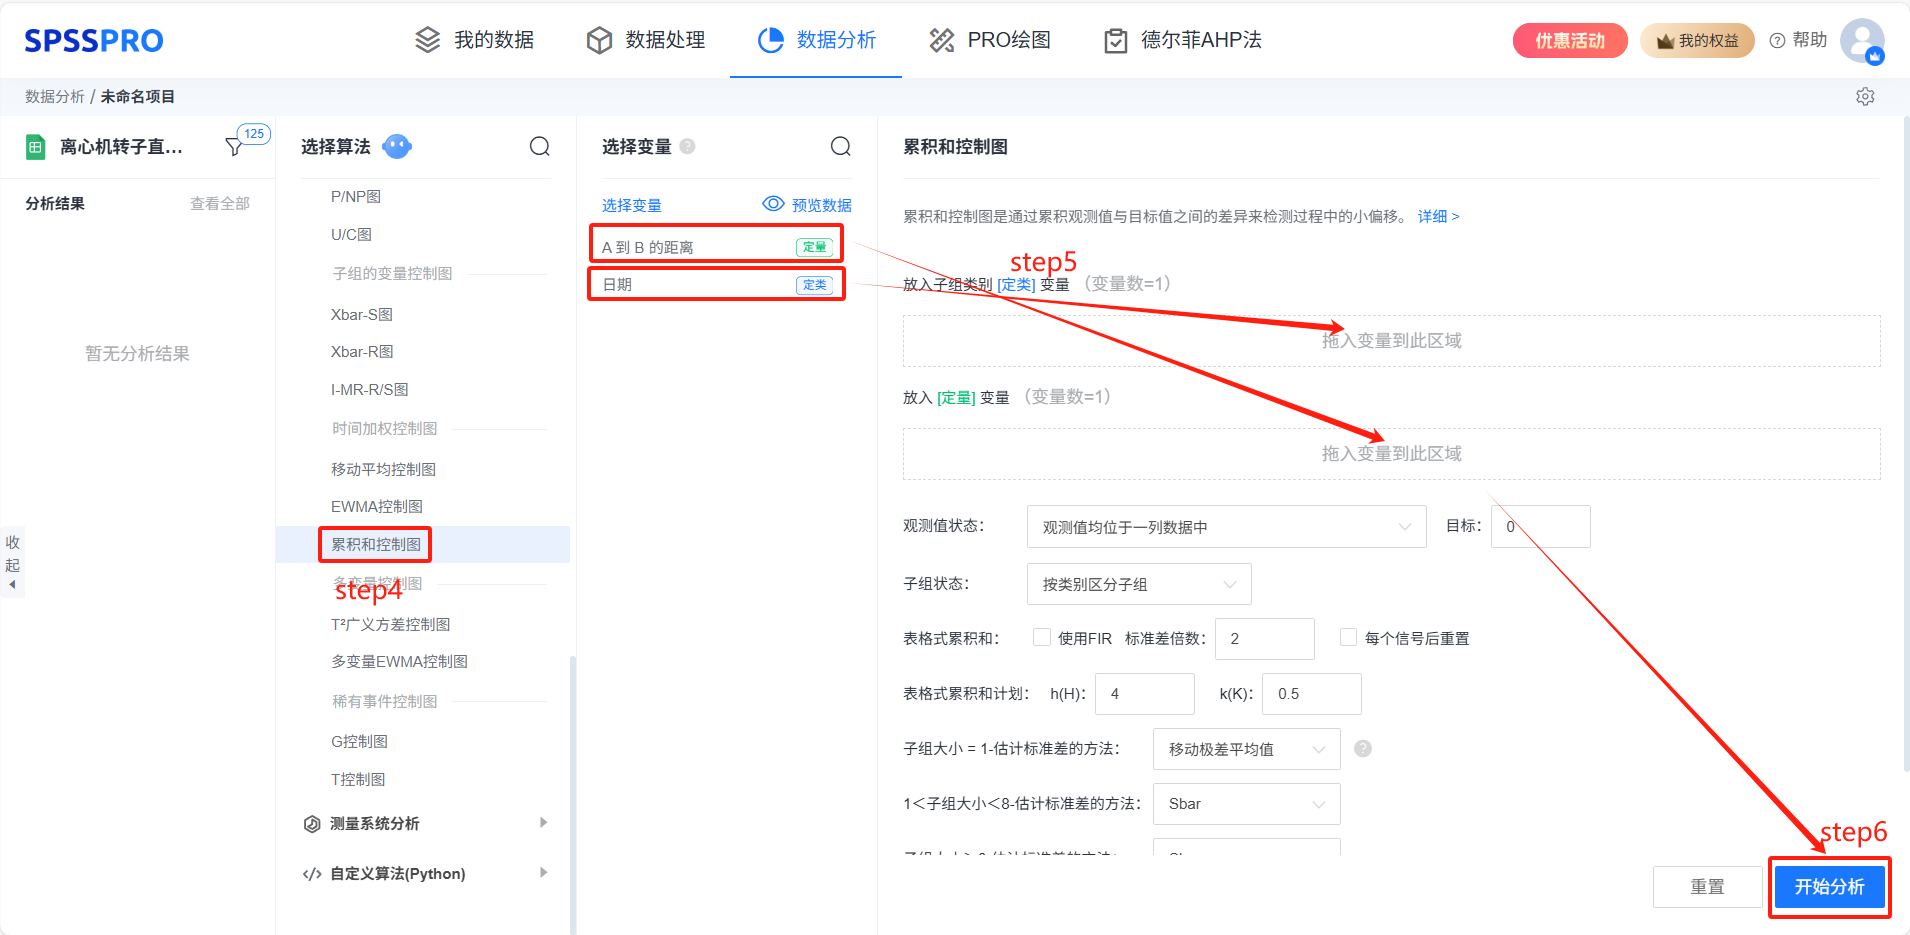
选择累计和控制图并输入变量

step4:选择【累计和控制图】;

step5:查看对应的数据数据格式,【累计和控制图】要求输入为1个定量变量或1个定量变量与定类变量的组合。

step6:点击【开始分析】,完成全部操作。

# 6、输出结果分析

输出结果1:累计和控制图 累计和控制图输出结果
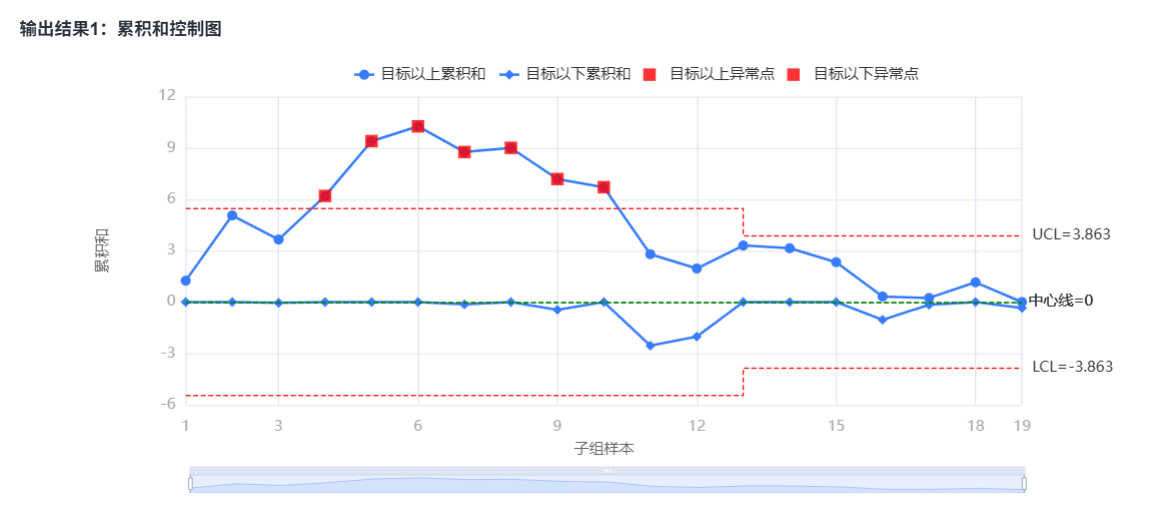
图表说明:累积和控制图通过累积观测值与目标值之间的差异来检测过程中的小偏移,进而标识和更正过程中的不稳定性。

# 7、注意事项

  • 数据应当是连续的:仅适用于连续型数据,不可用于离散型数据,离散型数据请使用属性控制图,如P控制图或U控制图。

  • 过程需满足“稳态”与“正态分布”:主要包括过程输出的 “中心位置” 无偏移,过程输出的 “离散程度” 无变化。

  • 数据一致性:确保 “子组大小、抽样间隔、测量标准” 统一。

# 8、模型理论

累计和控制图是一种通过累积过程偏差来快速检测微小均值偏移的统计过程控制工具。关于累计和控制图中包含的标绘点、中心线、控制上下限的公式计算如下:

(1)累计和控制图

上标绘点(圆点):表示目标以上的偏差的累积和(CUi)

CUi=max{0,CUi−1+x―i−(T+kσmi)}CU0=0

选择“使用FIR”之后,只需要在第一个目标以上的偏差累积和上加一个初始的FIR值,计算公式如下:

{FIR=fσmiCU0=0CU1=max{0,FIR+CU0+x―1−(T+kσm1)}CUi=max{0,CUi−1+x―i−(T+kσmi)},i=2,3,4...

在选择“使用FIR”的基础上,进一步选择了“每个信号后重置”,此时计算公式如下:

CLi=preCL+xi―−(T−kσmi)CUi=preCU+xi¯−(T+kσmi)

preCL和preCU分别代表CLi−1和CUi−1,m为子组大小,σ为过程标准差,不使用FIR时,CL0为0,使用FIR时,CL0为fσmi,每个信号后重置,如果preCL≤LCLi−1或preCU≤UCLi−1,在不使用FIR时:

preCL=preCU=0

在使用FIR时:

preCL=−fσmi−1preCU=fσmi−1

式中,CUi−1为前一个目标以上的累积和,xi¯为各子组均值(如果子组的大小为1,则就是对应的观测值),T为所设置的目标值(默认为为0),σ为过程标准差,mi为各子组中包含的观测值的个数,k为要检测的偏移大小(默认k=0.5),f为标准差的倍数(默认值为2),FIR为选择“使用FIR”快速初始反映值。

中心线:位于0的位置

下标绘点(菱形):表示目标以下的偏差的累积和(CLi)

CLi=min{0,CLi−1+x―i−(T−kσmi)}CL0=0

选择“使用FIR”之后,只需要在第一个目标以上的偏差累积和上加一个初始的FIR值,计算公式如下:

{FIR=fσmiCU0=0CL1=min{0,−FIR+CL1+x―1−(T−kσm1)}CLi=min{0,CLi−1+x―i−(T−kσmi)},i=2,3,4...

在选择“使用FIR”的基础上,进一步选择了“每个信号后重置”,此时计算公式如下:

CLi=preCL+xi―−(T−kσmi)CUi=preCU+xi¯−(T+kσmi)

preCL和preCU分别代表CLi−1和CUi−1,m为子组大小,σ为过程标准差,不使用FIR时,CL0为0,使用FIR时,CL0为fσmi,每个信号后重置,如果preCL≤LCLi−1或preCU≤UCLi−1,在不使用FIR时:

preCL=preCU=0

在使用FIR时:

preCL=−fσmi−1preCU=fσmi−1

式中,CLi−1为前一个目标以上的累积和,xi¯为各子组均值(如果子组的大小为1,则就是对应的观测值),T为所设置的目标值(默认为为0),σ为过程标准差,mi为各子组中包含的观测值的个数,k为要检测的偏移大小(默认k=0.5)。

控制上下限:

(1)累积和控制上限:

LCL=−hσmin(mi)

(2)累积和控制下限:

UCL=hσmin(mi)

式中,h为决策区间(默认值为4),σ为待估计的过程标准差,min(mi)为各子组中包含的最小观测值的个数。

异常点:

对超出上限、下限的点进行异常点标记(如圆点中包含一些红色的小矩形,此为超出累积和上限的点)。

(2)子组大小=1-估计σ的方法

移动极差平均值

其中MRi=max(xh,…,xi)−min(xh,…,xi), 其中 h=i−w+1MRavg=∑i=wnMRi(n−w+1)

使用MRavg计算估计σ(无偏估计):

σ=MRavg d2(w)

式中,MRi是观测值i的移动极差,n是观测值的个数,w是移动极差的长度(默认的长度为2),MRavg是移动极差平均值。

移动极差中位数

其中MRi=max(xh,…,xi)−min(xh,…,xi), 其中 h=i−w+1MRmedian =median(MRw,…,MRi)

使用MRmedian 计算估计σ(无偏估计):

σ=MRmedian d4(w)

式中,MRi是观测值i的移动极差,n是观测值的个数,w是移动极差的长度(默认的长度为2),MRmedian 是移动极差中位数。

递差均方和平方根

使用无偏常量时

SRMSSD=12×∑i=2Ndi2M−1c4′(N)

不使用无偏常量时

SRMSSD=12×∑i=2Ndi2M−1

式中,d_i是观测值i与观测值i-1之间的差值,M是观测值的个数。

(3)子组大小>1-估计σ的方法

Rbar方法默认使用无偏常量,计算方式如下:

如果使用无偏常量,使用每个子组的极差ri计算Sr,它是σ的无偏估计量:

Sr=∑ifirid2(ni)∑ififi=[d2(ni)]2[d3(ni)]2

如果每个子组的大小相等,则按照以下公式计算Sr:

Sr=∑iriNd2(ni)

Sbar方法计算方式如下:

如果不使用无偏常量,则σ为子组标准差的均值。计算如下:

S―=σS―=∑i=1NSiN

其中S―是指子组标准差均值,N是指子组的数量,Si是指各个子组的标准差。

如果使用无偏常量,则Sbar的计算方式如下:

S―=∑ihiSic4(ni)∑ihihi=(c4(ni))21−(c4(ni))2c4(n)=2n−1Γ(n2)Γ(n−12)

上述式子中如果每个子组的样本量是相等的,则Sbar为:

S¯=∑iSiNc4(ni)

式中,Si是指各个子组的标准差,Γ(.)是Gamma函数,N为子组数。

合并标准差的计算方式如下:

如果不使用无偏常量,计算公式如下:

Sp=∑i∑j(xij−x―i)2∑i(ni−1)

如果每个子组的大小相等,则按照以下公式计算合并标准差(即为子组方差的均值):

Sp=∑i∑j(xij−x―i)2∑i(ni−1)=∑i=1N(ni−1)Si2∑i=1N(ni−1)=∑iSi2N

其中xij为第i个子组的第j个观测值,x―i为子组i的均值,ni是指第i个子组的样本数,Si指第i个子组的样本标准差,N指子组数。

如果使用无偏常量,计算公式如下:

Sp=∑i∑j(xij−x―i)2c4(ni)(d+1)d=∑i(ni−1)c4(n)=2n−1Γ(n2)Γ(n−12)

式中,d为Sp的自由度,Γ(.)是Gamma函数。

如果每个子组的大小相等,则按照以下公式计算合并标准差:

Sp=∑iSi2Nc4(ni)(d+1)

# 9、参考文献

[1]Scientific Platform Serving for Statistics Professional 2021. SPSSPRO. (Version 1.0.11)[Online Application Software]. Retrieved from https://www.spsspro.com.

[2]Montgomery D C. Introduction to statistical quality control[M]. John wiley & sons, 2020.

建议反馈