属性一致性分析
# 1、作用
属性一致性分析是评估多人对同一组样本进行分类或评级时一致性程度的统计方法,核心作用在于量化评估 “判断可靠性”。
# 2、输入输出描述
输入:检验员信息和样本信息、评价值与标准值
输出:检验员自身正确性和一致性、检验员之间的正确性和一致性
# 3、案例示例
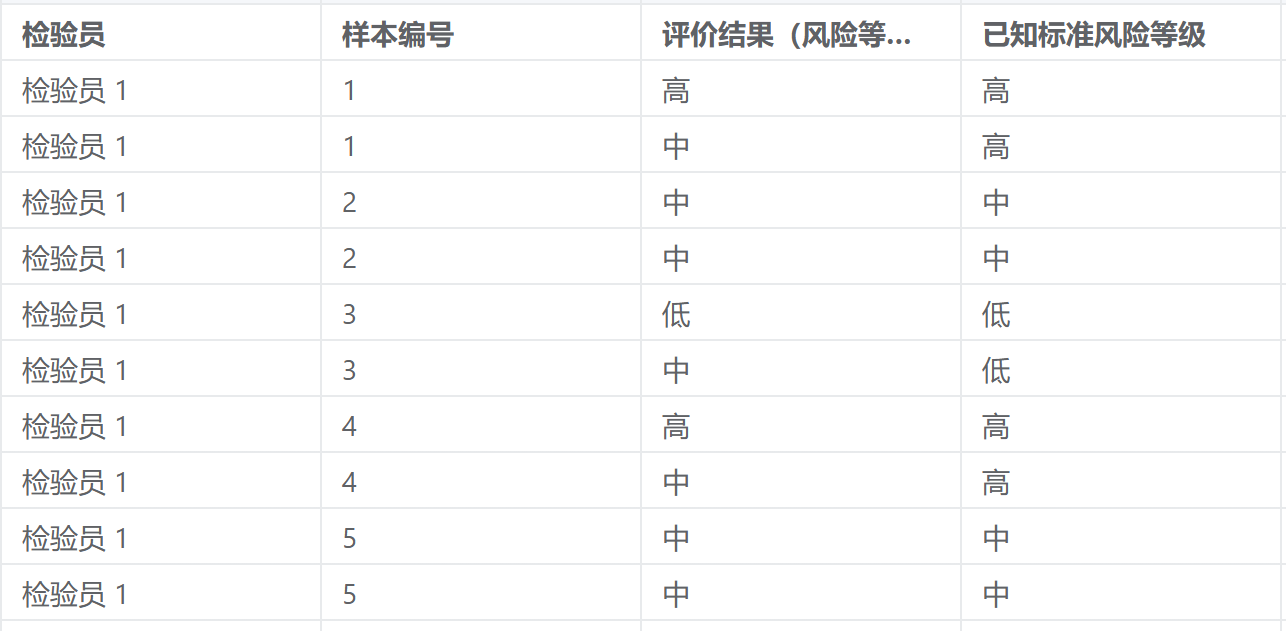
案例:某建筑公司对 10 个在建工地(样本)进行安全隐患排查,安排 3 名安全检验员(检验员 1、2、3)各对每个工地开展 2 次独立检查,将安全隐患风险等级划分为 低风险(设备轻微老化)、中风险(防护措施缺失)、高风险(结构稳定性问题) 。已知标准结果由行业专家团队根据现场检测数据和规范统一评定
# 4、案例数据
# 5、案例操作
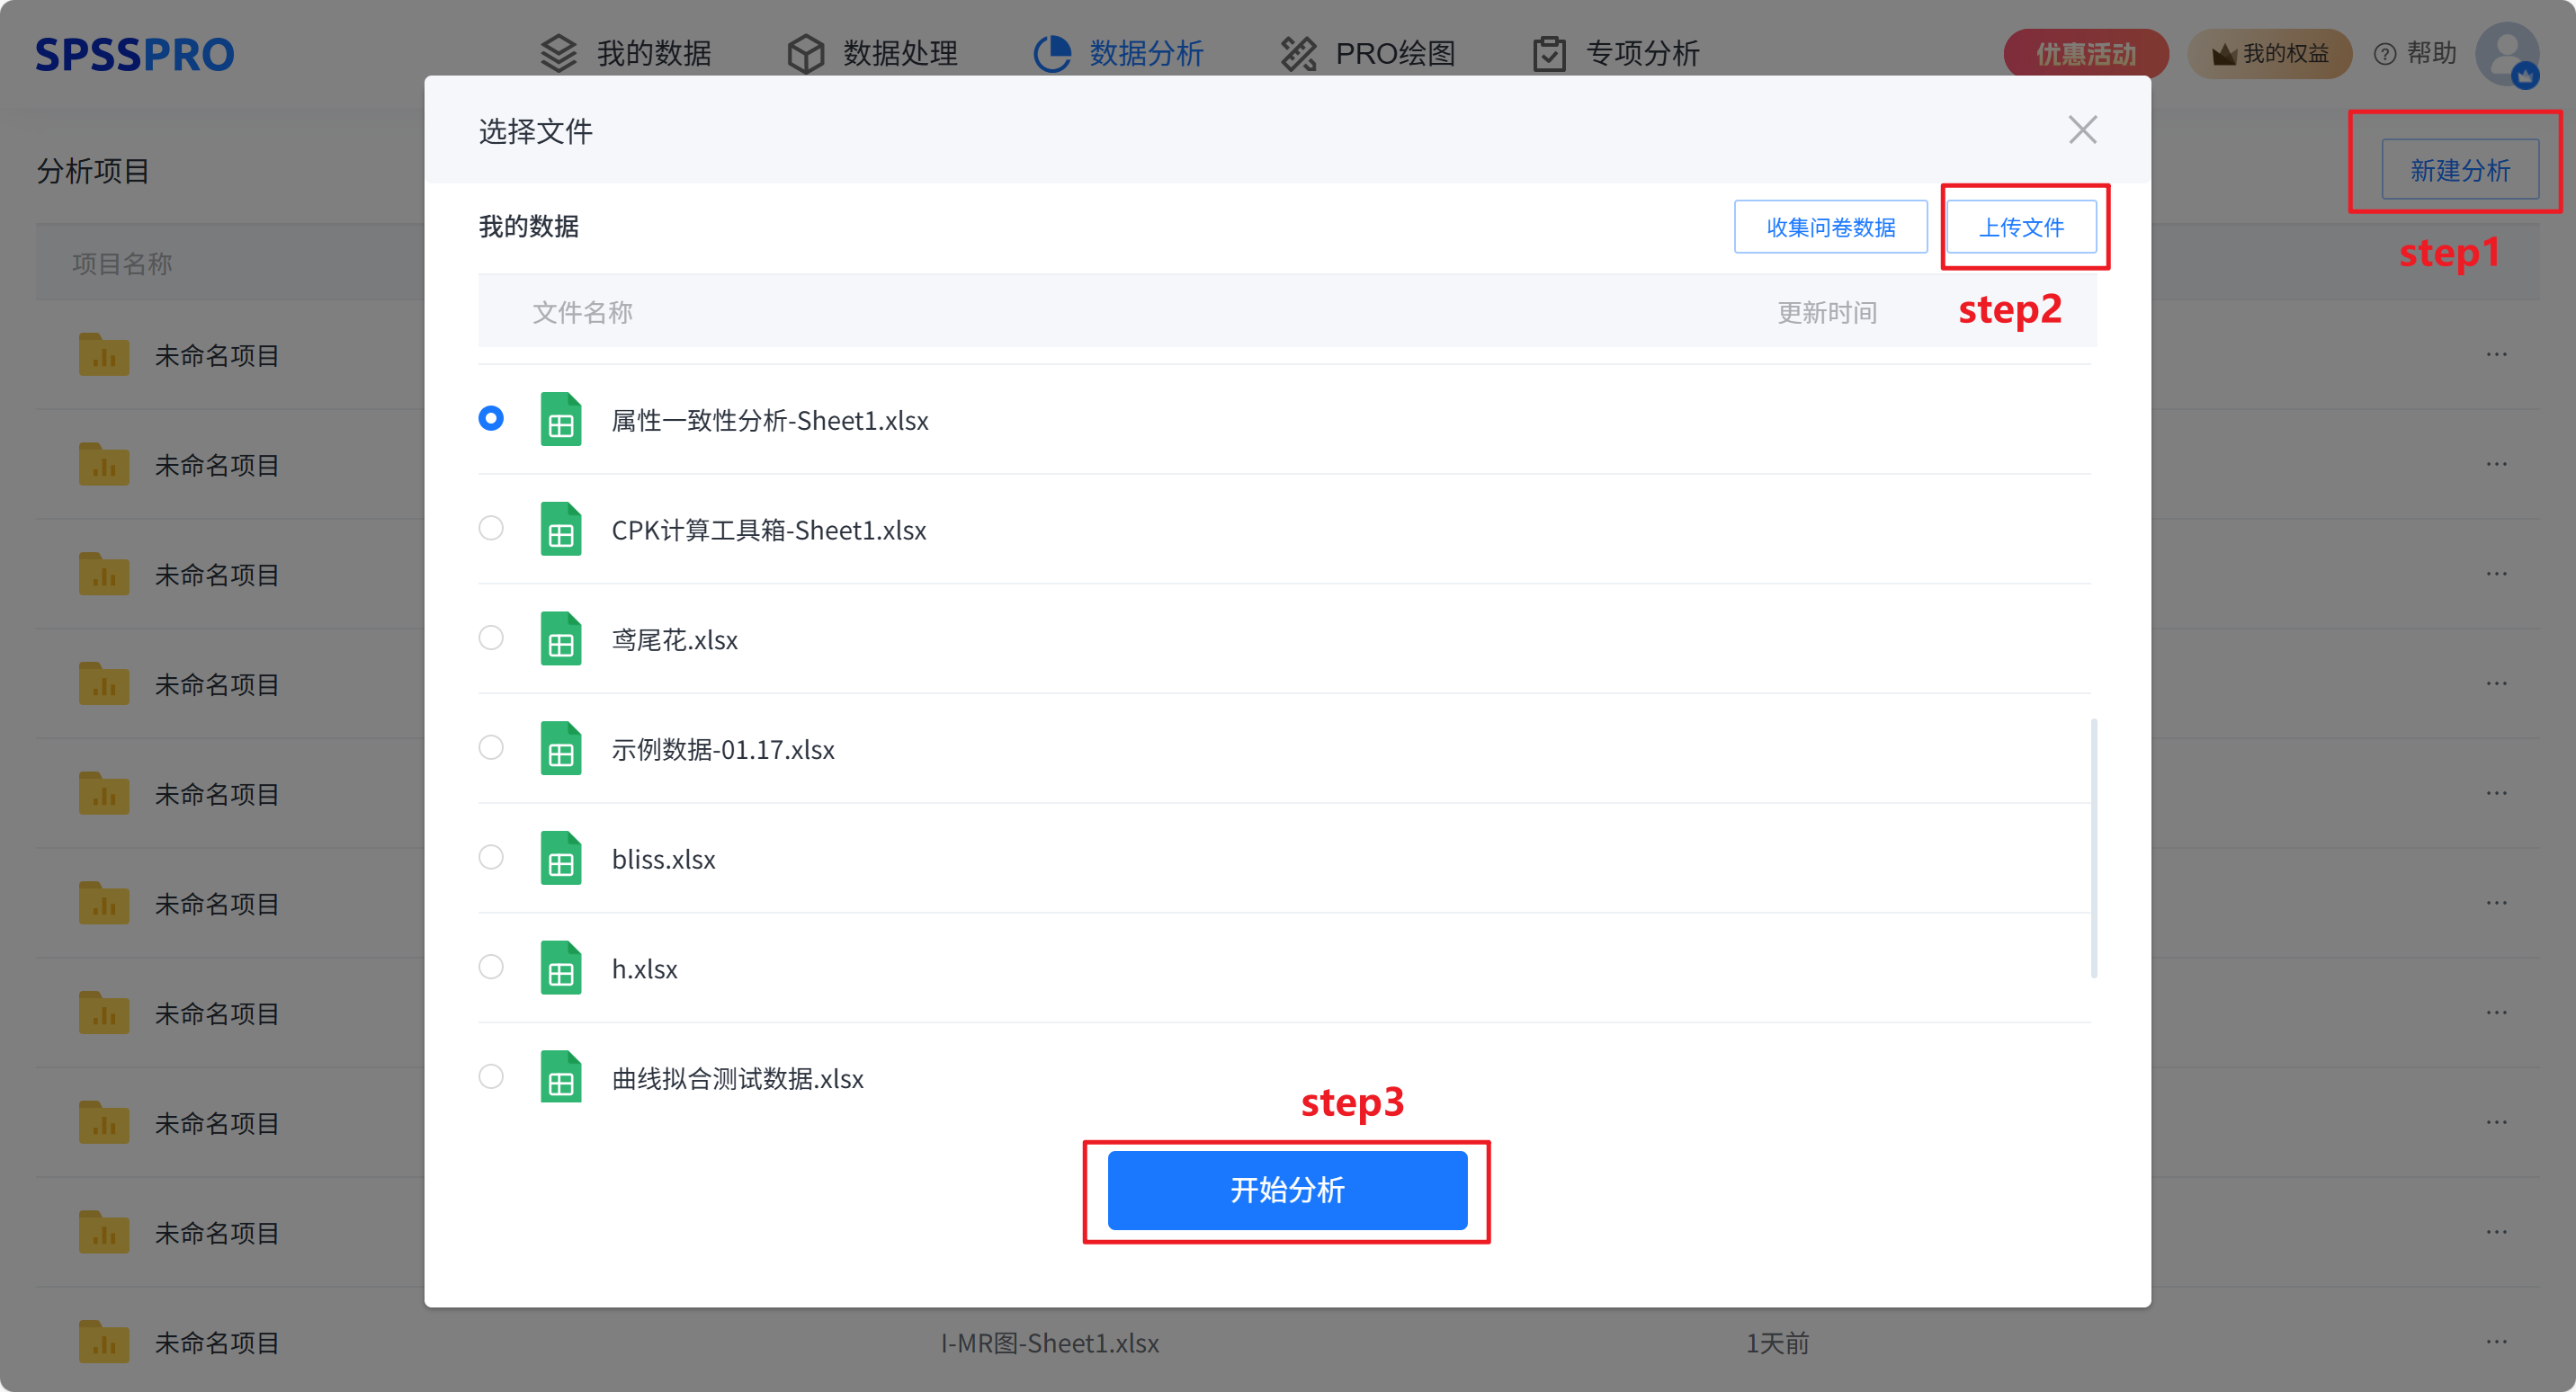
Step1:新建分析;
Step2:上传数据;
Step3:选择对应数据打开后进行预览,确认无误后点击开始分析;
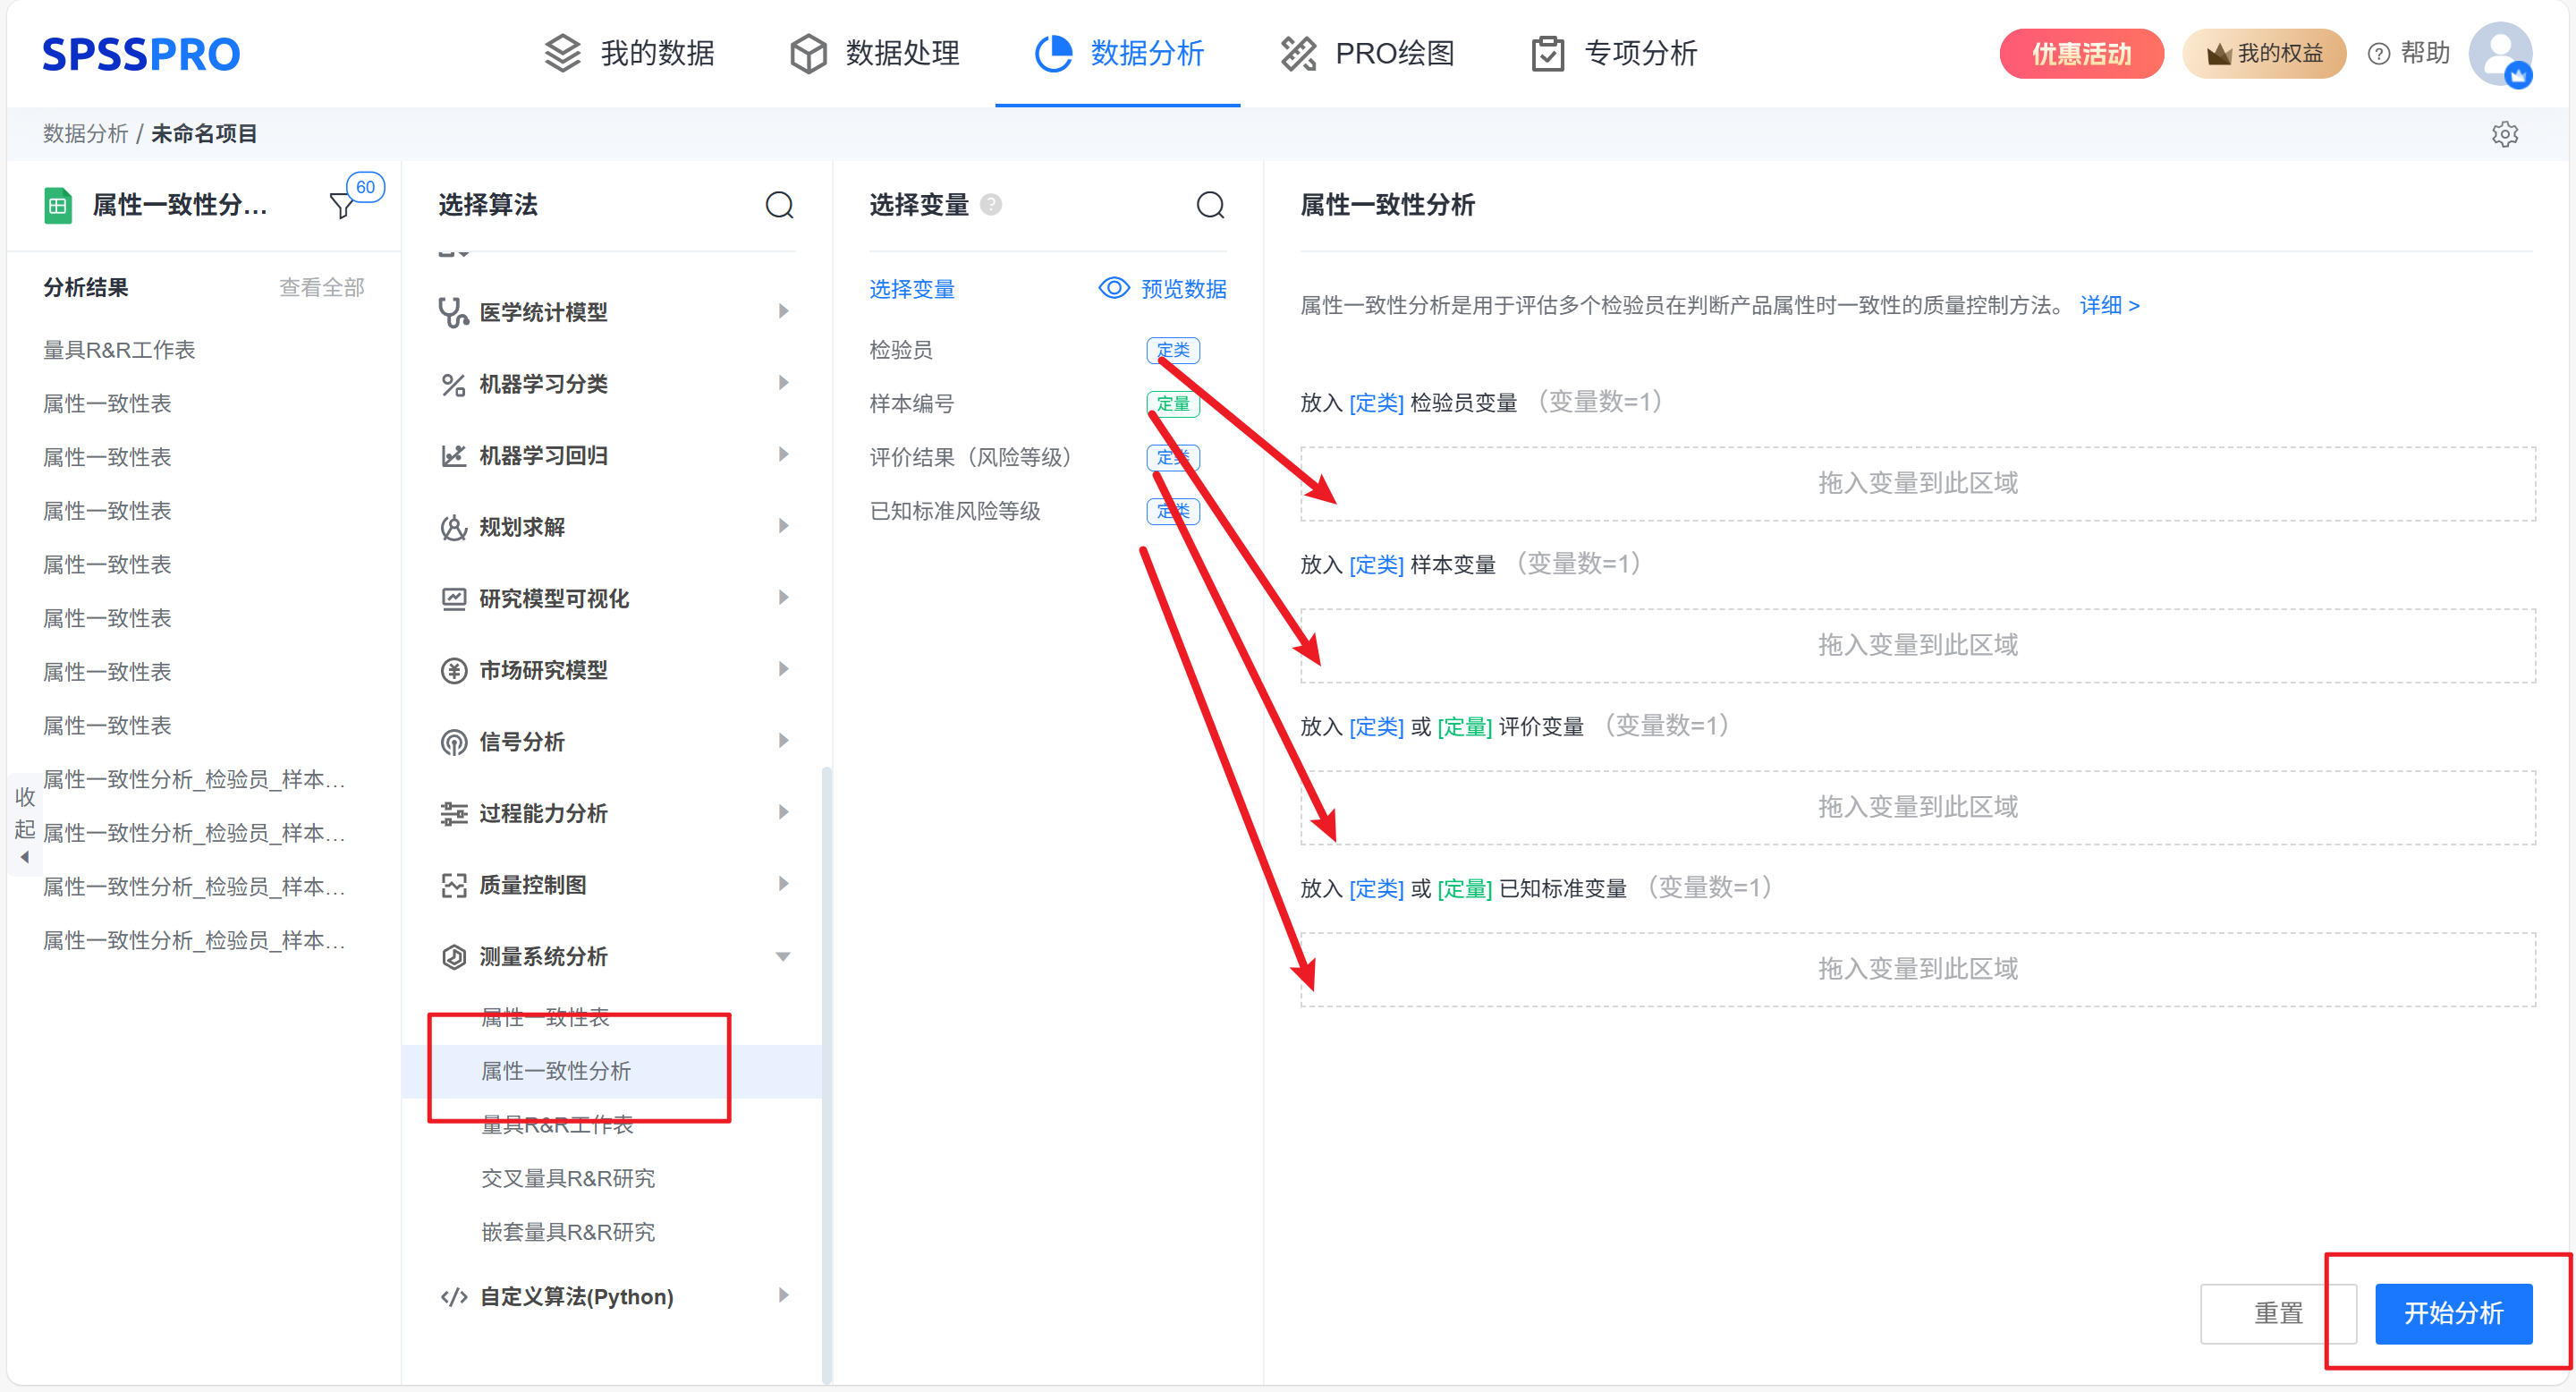
step4:选择【属性一致性分析】;
step5:查看对应的数据数据格式,【属性一致性分析】要求输入数据为一项定量变量;
step6:点击【开始分析】,完成全部操作。
# 6、输出结果分析
输出结果1:属性一致性图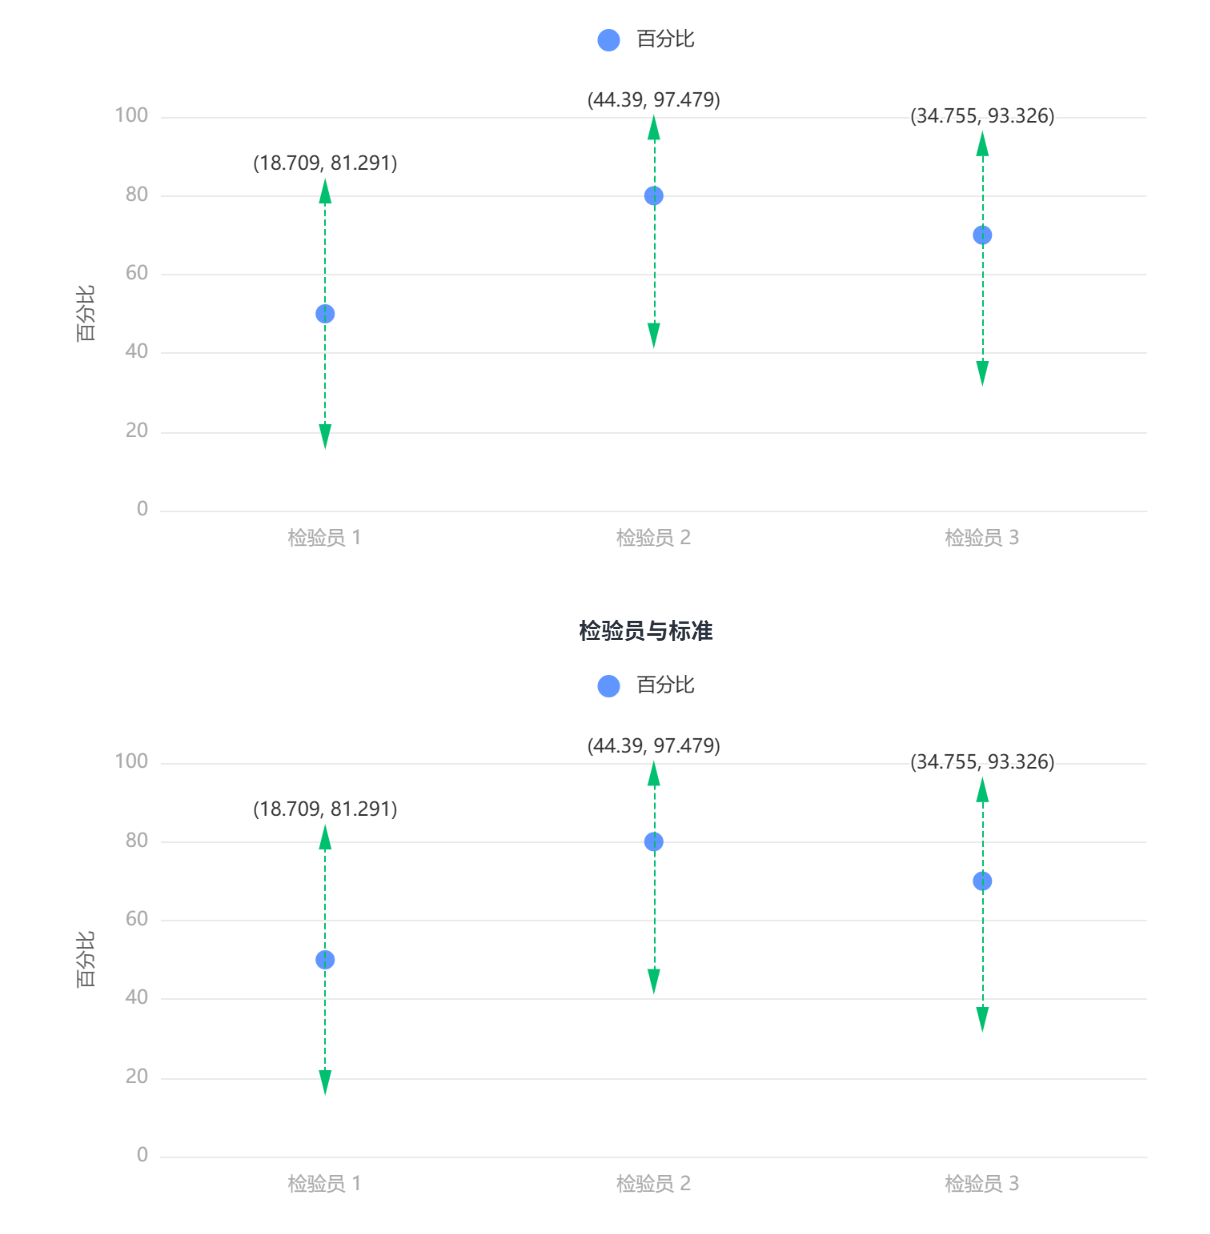
图表说明:上图直观展示检验员在属性判断上的一致性情况。
(1)检验员一致性:用来评估每位检验员在多次重复测量中的一致性(即他们自己前后判断是否一致),这个图只有在存在多个重复测量(即重复数 ≥ 2)时才会显示。因为没有重复,就无法比较“同一个检验员是否给出了相同的判断”。
● 高匹配百分比且窄的置信区间:如果某位检验员的匹配百分比较高(接近100%)且置信区间较窄,说明该检验员在评分时非常一致,且这种一致性有较高的可信度。这意味着该检验员评分稳定,评级的一致性较好。
● 低匹配百分比且置信区间宽:如果匹配百分比较低,并且置信区间很宽,说明该检验员的评分存在较大的不稳定性,可能会影响整体质量控制和评估的一致性。此时,可能需要对该检验员进行培训或调整评分标准。
(2)检验员正确性:用来评估每位检验员的判断是否符合标准值(即他们的判断是否正确)
● 匹配百分比高且置信区间窄:如果检验员的匹配百分比接近100%,并且置信区间很窄,说明该检验员评分与标准一致性非常高,并且这种一致性具有高度的统计可信度。检验员在评分时能够准确地反映标准。
● 匹配百分比低且置信区间宽:如果检验员的匹配百分比较低,且置信区间较宽,说明该检验员与标准之间的评分存在较大偏差,并且其评分的一致性不稳定,可能不符合预期标准。
输出结果2:每位检验员的一致性
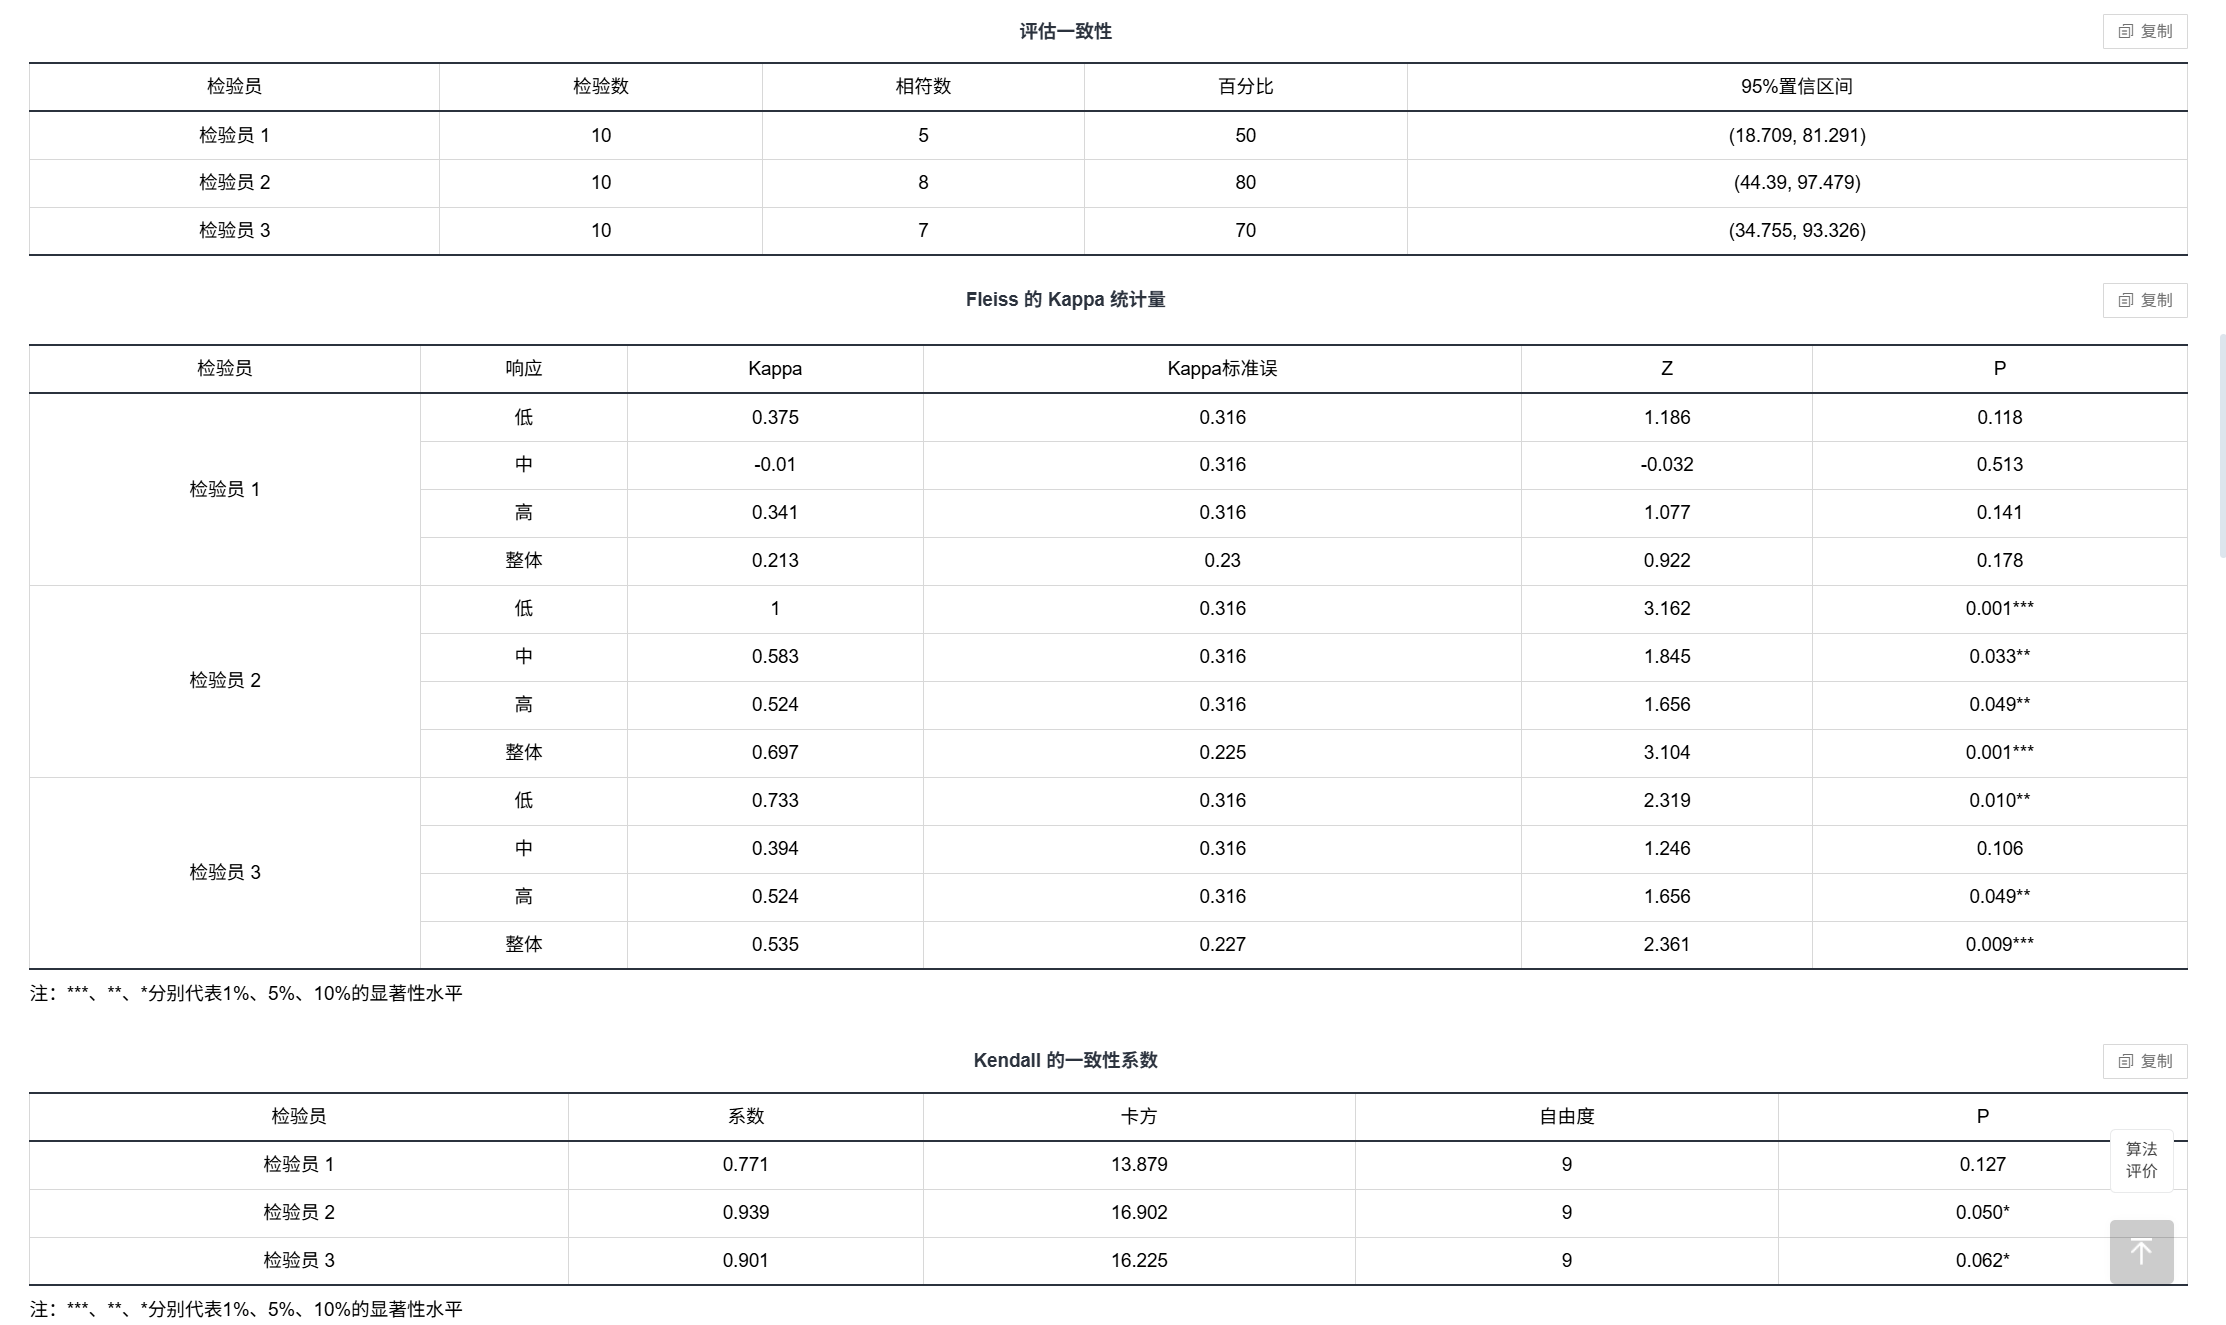
图表说明:分析每位检验员在重复测量中自身判断是否一致。
输出结果3:每位检验员的正确性
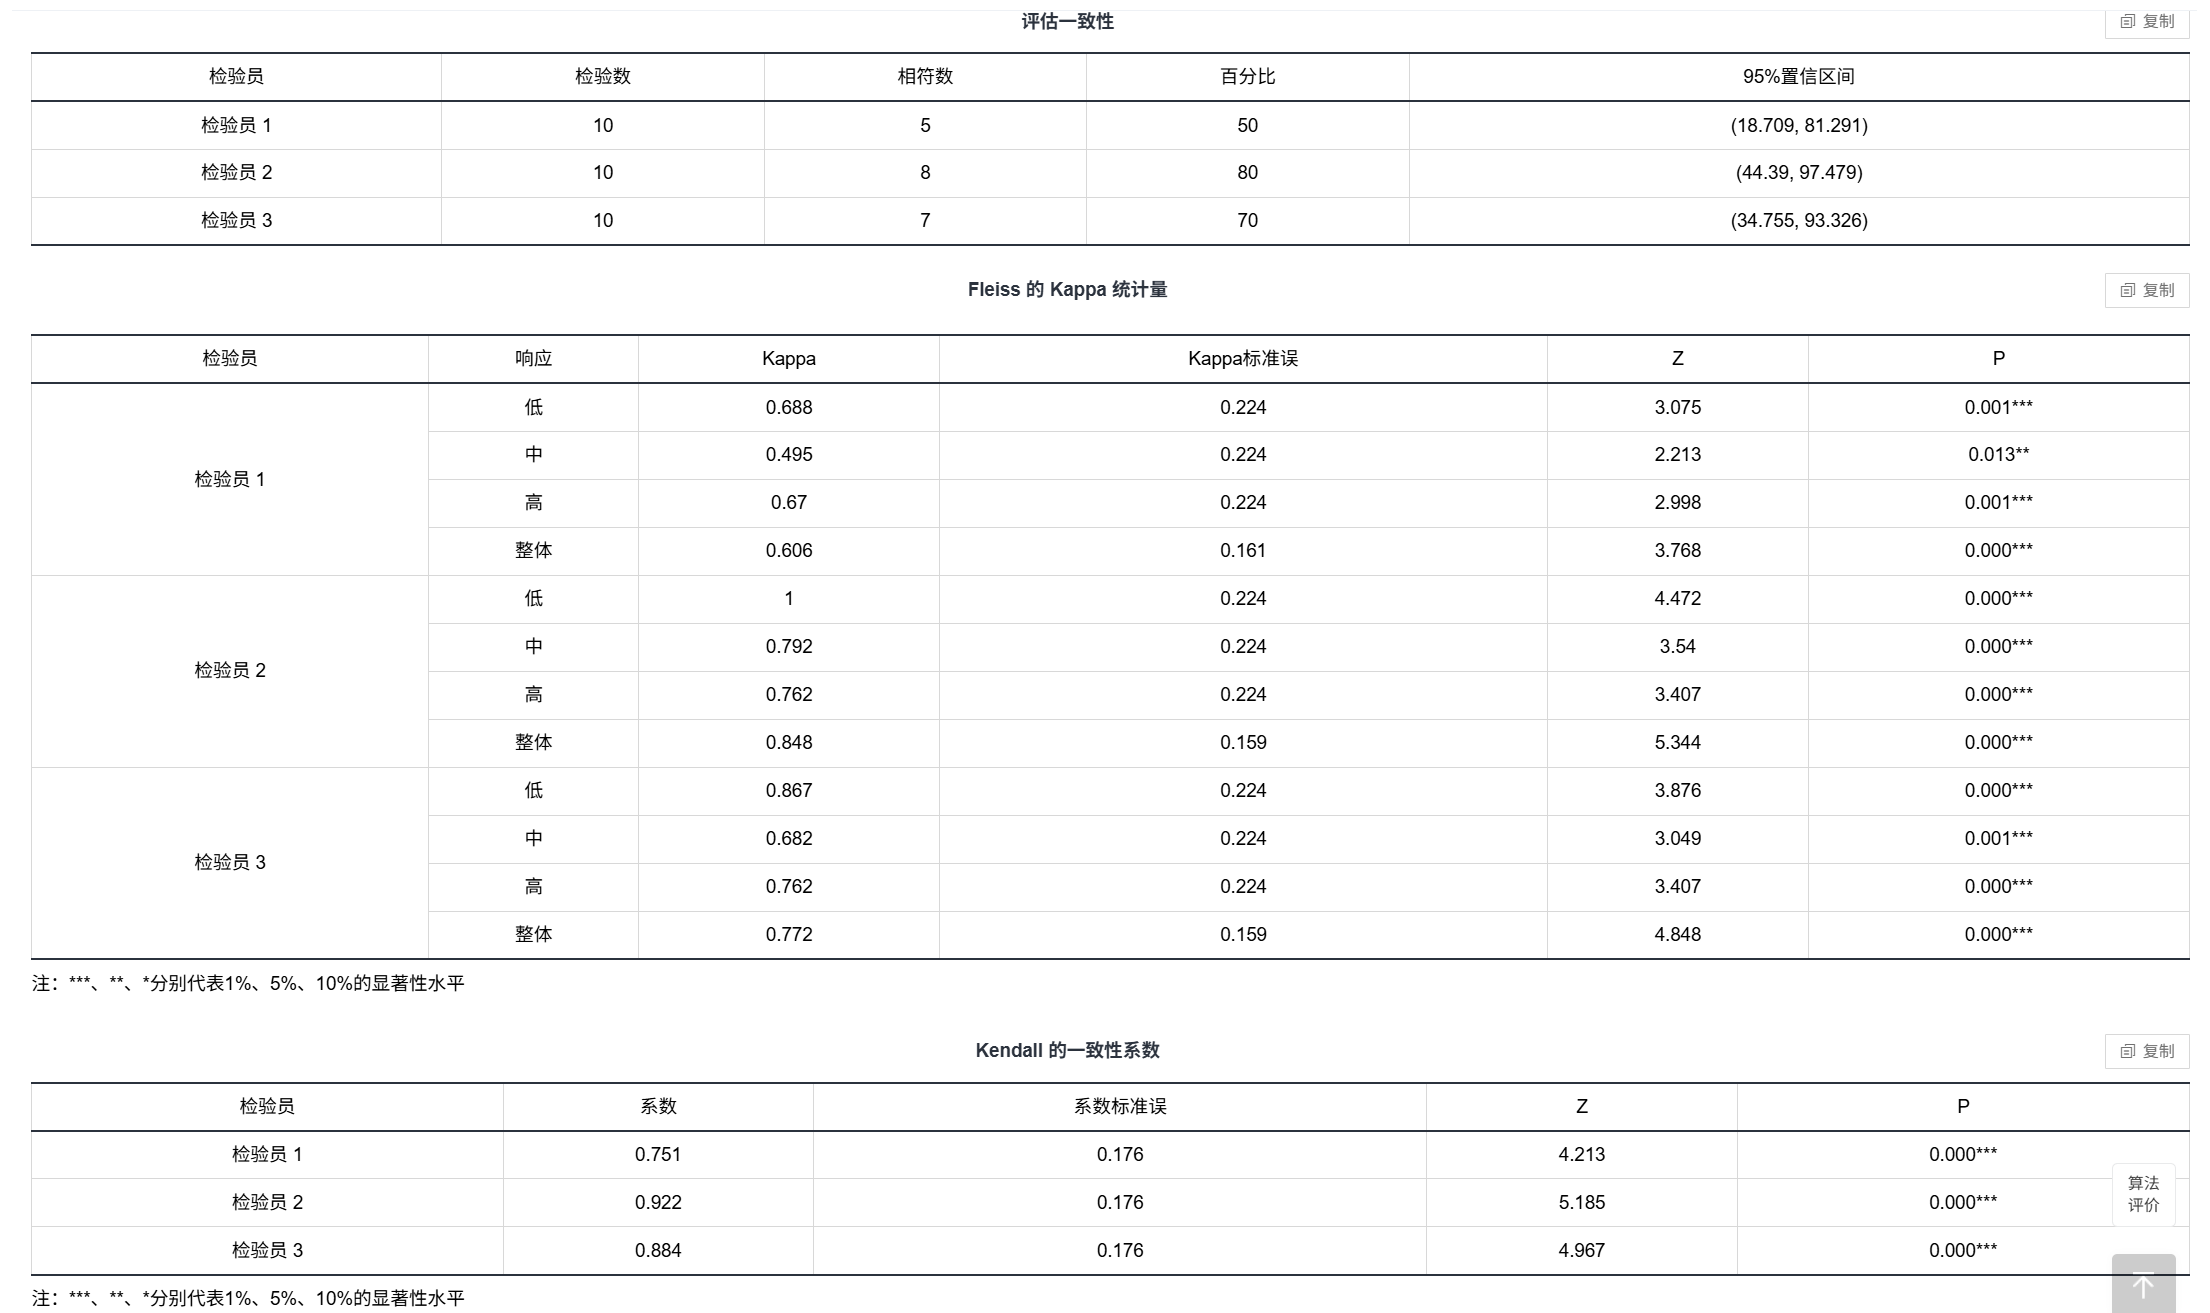
图表说明:分析每位评估员的响应是否与标准或预期结果一致,评估员在响应时的准确性对于质量控制至关重要。
输出结果4:检验员之间的一致性
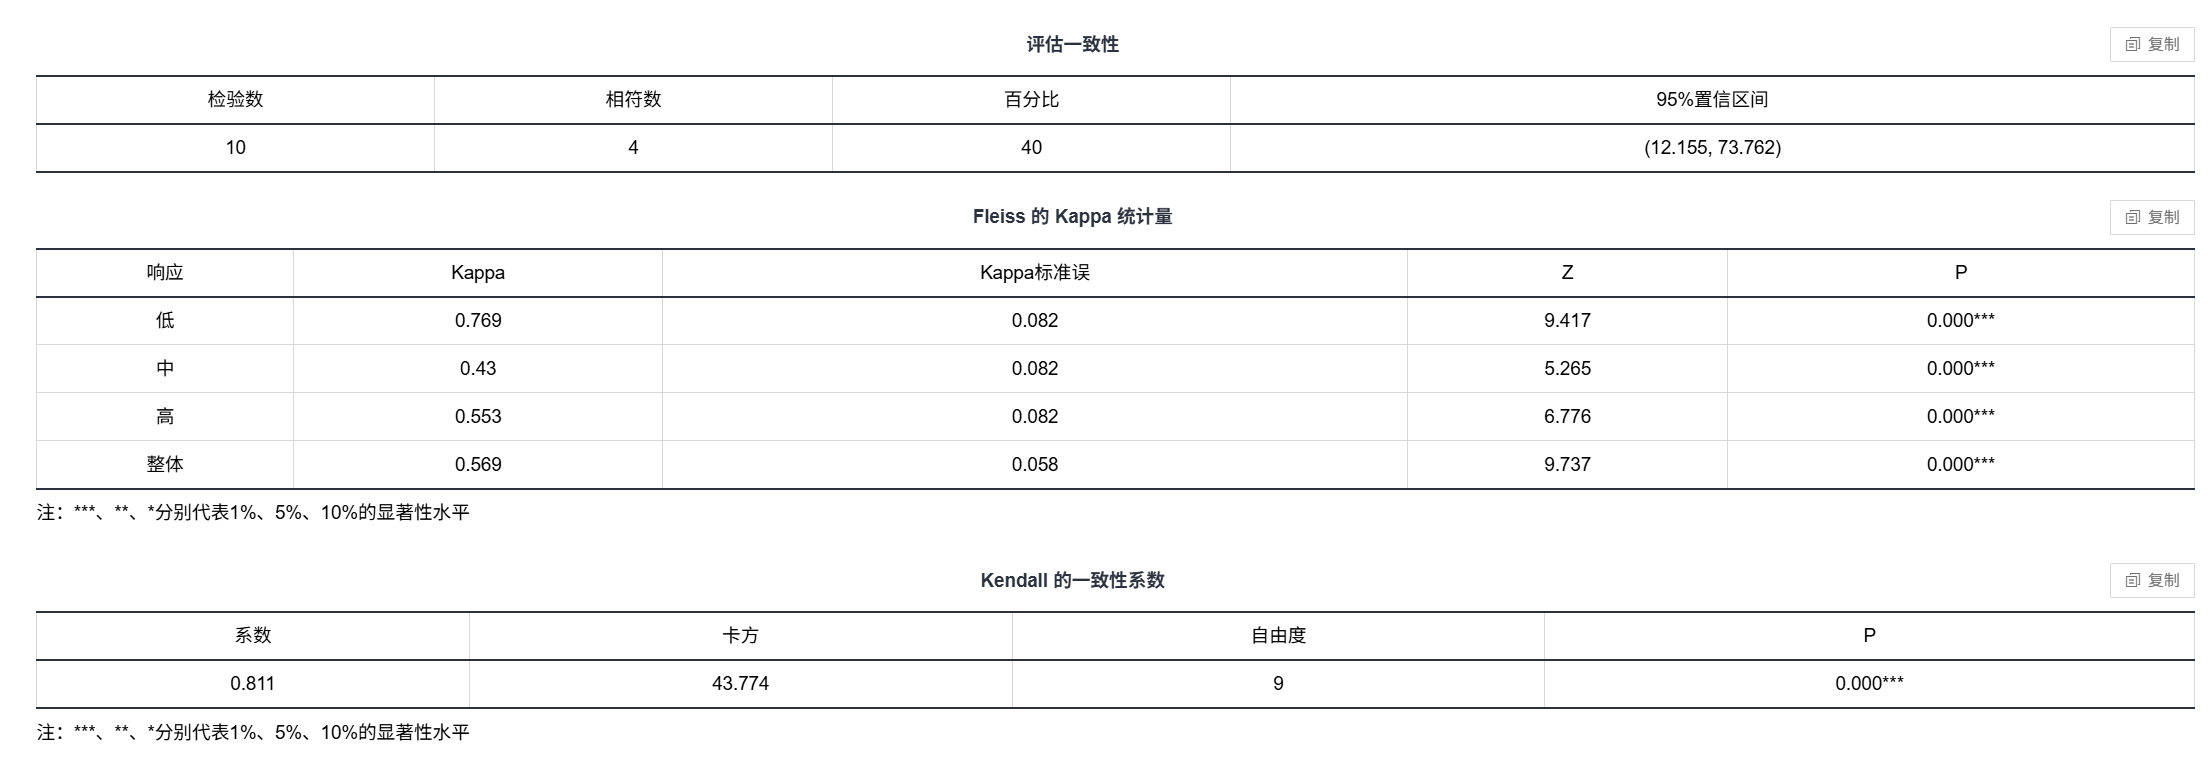
图表说明:分析多个评估员对相同项目的评分一致性。通过比较不同评估员之间的评分,可以帮助了解评估员之间的可靠性和一致性。
输出结果5:所有检验员的正确性
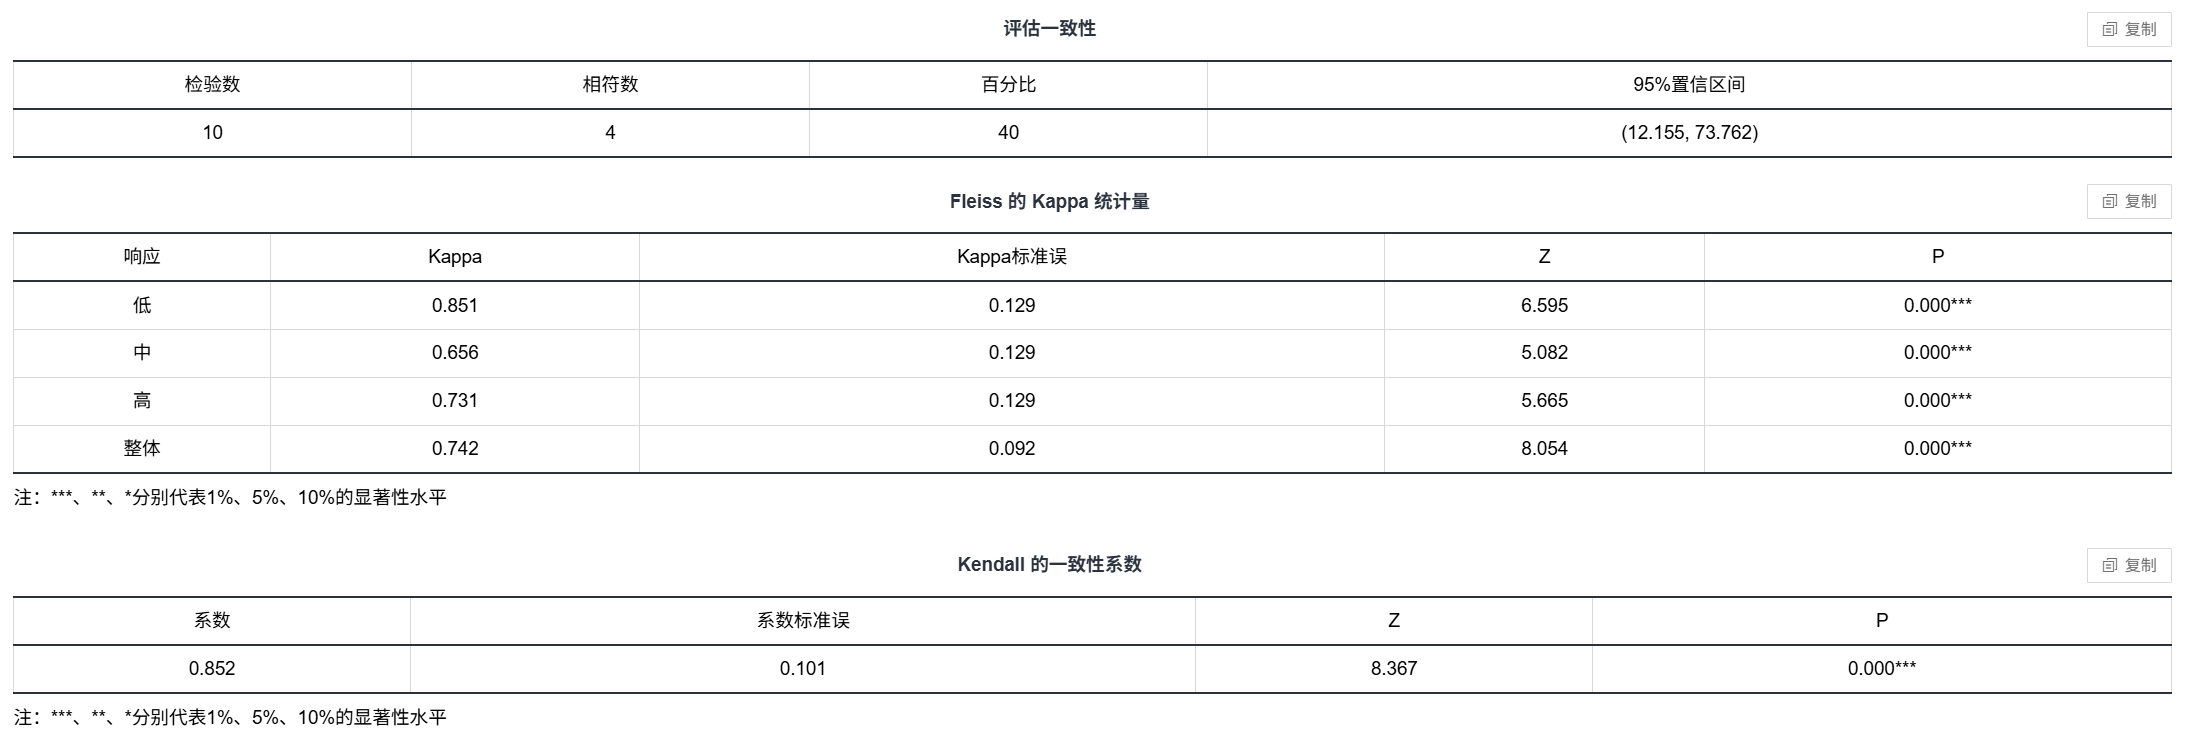
图表说明:评估所有评估员对项目的评分与标准之间的一致性和正确性。此图表展示了整个评估组在响应准确性方面的综合表现。
# 7、注意事项
若是评价值和标准值的类别是有序的,需要修改其类别的编码顺序,以保证kendall的结果是准确的。
# 8、模型理论
属性一致性分析是针对定性测量系统(如合格 / 不合格、缺陷分类等离散型结果)的可靠性评估方法,核心原理是通过统计 “判定结果的一致性程度”,判断测量系统(包括操作员、标准、环境等)是否稳定可靠。其核心逻辑是:排除随机巧合因素后,评估 “真实一致性” 的比例,而非单纯依赖表面上的吻合次数。
属性测量的结果往往依赖主观判断(如 “合格” 与 “不合格” 的界定),因此误差主要来自:
(1)操作员自身的一致性(同一人多次判断同一对象是否一致);
(2)操作员之间的一致性(不同人判断同一对象是否一致);
(3)与标准的一致性(判断结果与 “真值 / 标准” 是否一致)。
属性一致性分析的核心指标(针对定性 / 分类数据):
(1)一致性比例(Agreement Percentage)
- 定义:直接计算 “实际一致的判定次数占总次数的比例”,是最直观的指标。
- 适用场景:快速判断定性测量系统(如合格 / 不合格、缺陷类型)的一致性,不考虑随机巧合。
- 公式:一致性比例 =( 一致的判定次数/总判定次数)*100%
(2)Kappa 系数(κ 系数)
- 定义:消除因数据分布(如多数样本为 “合格”)导致的随机巧合,如果零件本身大部分是合格的(比如实际合格占 90%),哪怕检验员随便瞎猜 “合格”,也可能蒙对很多次。这种 “靠运气蒙对” 的情况,就是 “机会性一致”,而 Kappa 系数的作用就是把这种 “运气成分” 剔除掉。
- 适用场景:属性数据(名义数据,如颜色分类、合格 / 不合格)的一致性评估,是属性一致性分析的核心指标。
(3)Kendall 系数(τ 系数)
- 定义:衡量两个有序变量(如等级评分:优 / 良 / 中 / 差)之间的相关性或一致性,反映 “排序趋势” 的吻合程度。
- 适用场景:有序数据(如评分、等级)的相关性分析,而非属性数据的一致性评估。例如:两个评委对 10 部电影的 “优 / 良 / 中” 评分是否趋势一致。
# 9、参考文献
[1]Scientific Platform Serving for Statistics Professional 2021. SPSSPRO. (Version 1.0.11)[Online Application Software]. Retrieved from https://www.spsspro.com.