公差区间
# 1、作用
公差区间算法的核心作用是确定一个统计范围,该范围能够以指定的置信水平(如 95%)保证包含总体中至少指定比率(如 99%)的数据。它不同于置信区间(仅估计总体参数,如均值),而是直接针对总体中个体值的分布范围,广泛应用于质量控制、工程设计、可靠性分析等领域,用于判断产品性能是否在可接受的波动范围内,或验证生产过程的稳定性。
# 2、输入输出描述
输入:1个定量变量。
输出:每个变量的公差区间。
# 3、案例示例
案例:某电子厂生产的片式电阻器,工程师需要确定一个公差区间,以 95% 的置信水平保证该区间包含至少 99% 的电阻器实际阻值,用于制定产品出厂的合格范围。
# 4、案例数据

# 5、案例操作
 Step1:新建分析;
Step2:上传数据;
Step3:选择对应数据打开后进行预览,确认无误后点击开始分析;
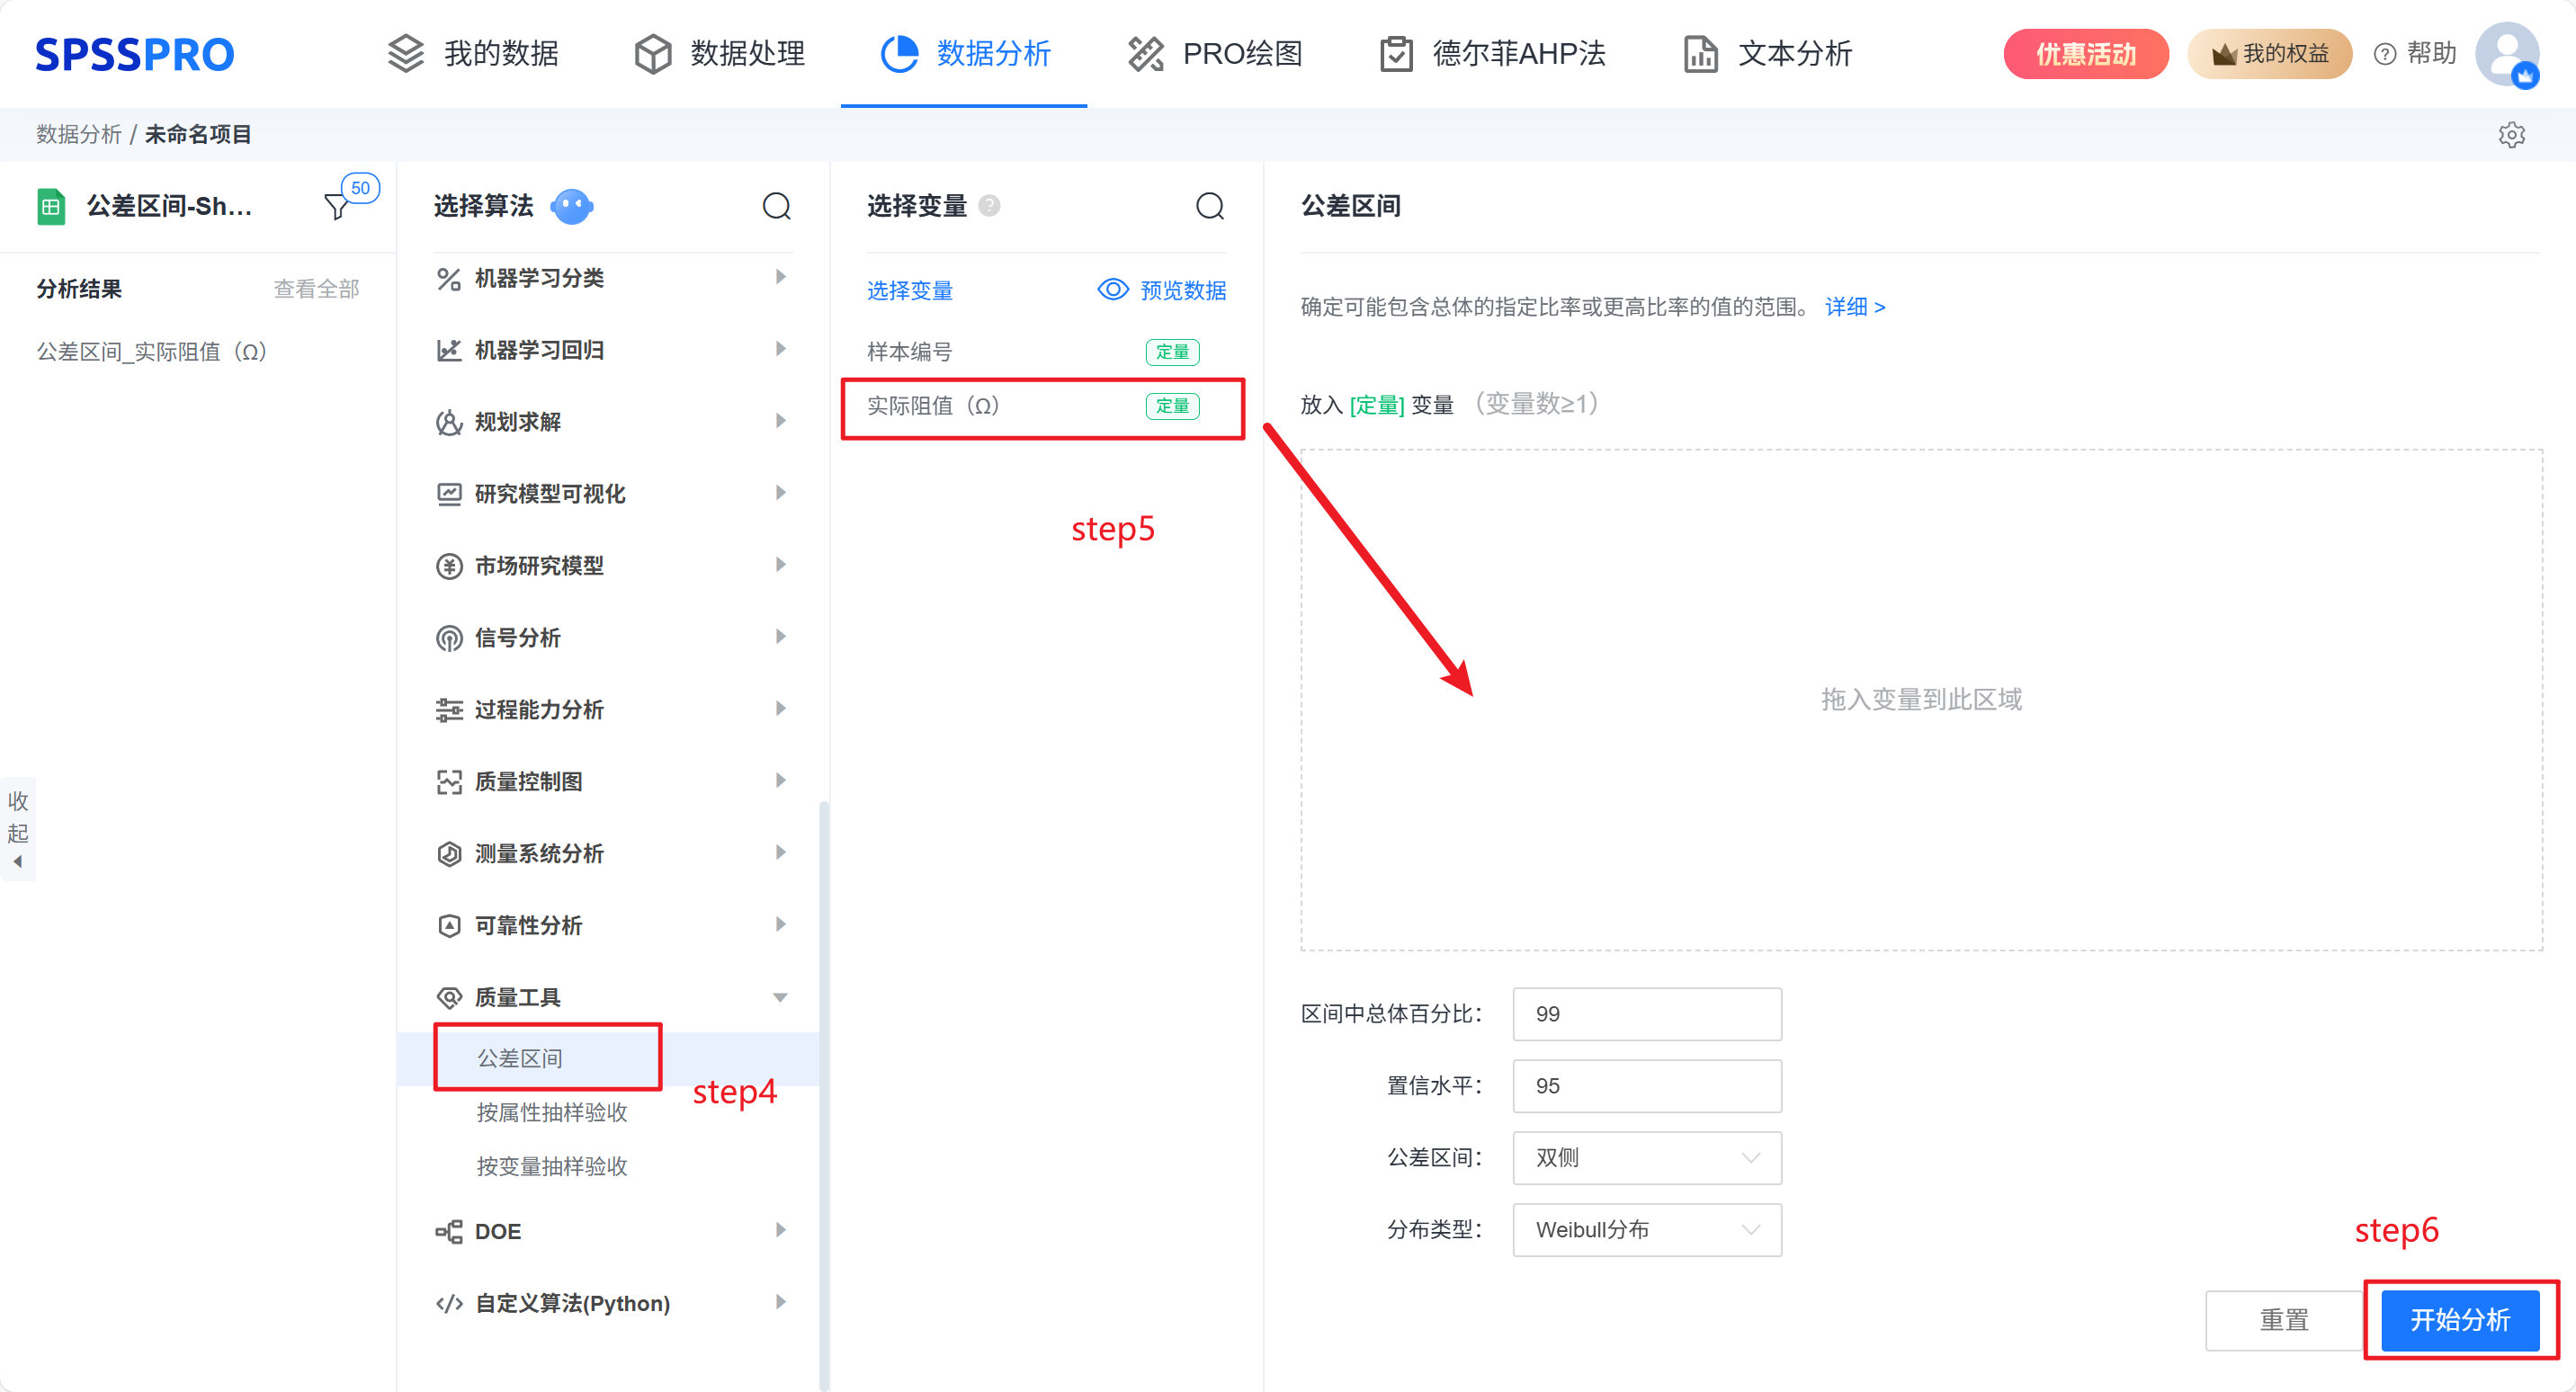 step4:选择【公差区间】;
step5:查看对应的数据数据格式和参数
(1)输入待分析变量,可支持对1个或多个定量变量进行分析
(2)区间中总体百分比:指期望落入公差区间内的总体个体的比例,例如设定p=99%,即要求该公差区间能包含总体中 95% 的个体能力 / 指标值。
(3)置信水平:指 公差区间能实际覆盖p比例总体 这一事件的置信概率 ,反映区间的统计可靠性。例如设定置信水平为 95%、总体百分比p=99%,即有 95% 的把握认为,该区间能包含总体中 99% 的个体。
(4)公差区间:双侧区间、单侧下限、单侧上限
(5)分布类型:计算公差区间的前提假设,直接决定区间的计算方法和精度
step6:点击【开始分析】,完成全部操作。
# 6、输出结果分析
输出结果1:描述统计

图表说明:上表展示了描述统计结果。可以看到P>0.25,满足威布尔分布,可以进行后续的分析;
输出结果2:公差区间

图表说明:上表展示了公差区间。该范围能够以指定的置信水平(如 95%)保证包含总体中至少指定比率(如 99%)的数据。使用Weibull分布, 可以95.0%置信度确信,在所有测量值中,至少有99%的测量值位于(41.683, 56.744)。假设无法确定数据服从Weibull分布,请使用非参数方法公差区间(47.297, 55.825)。对于非参数方法,取得的置信度为 8.944%。
输出结果3:数据分布
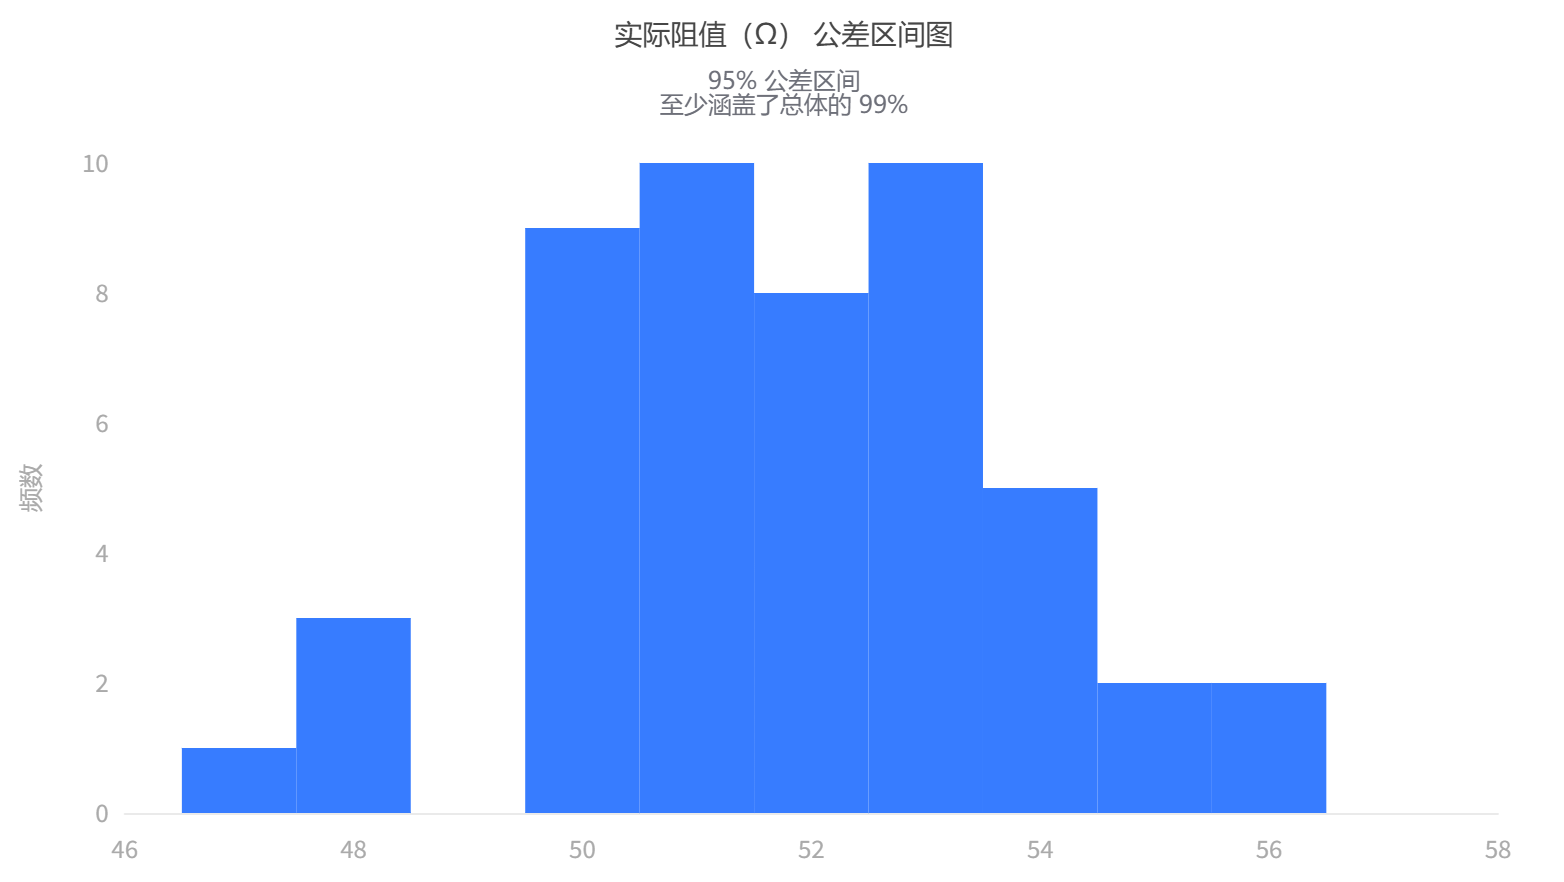
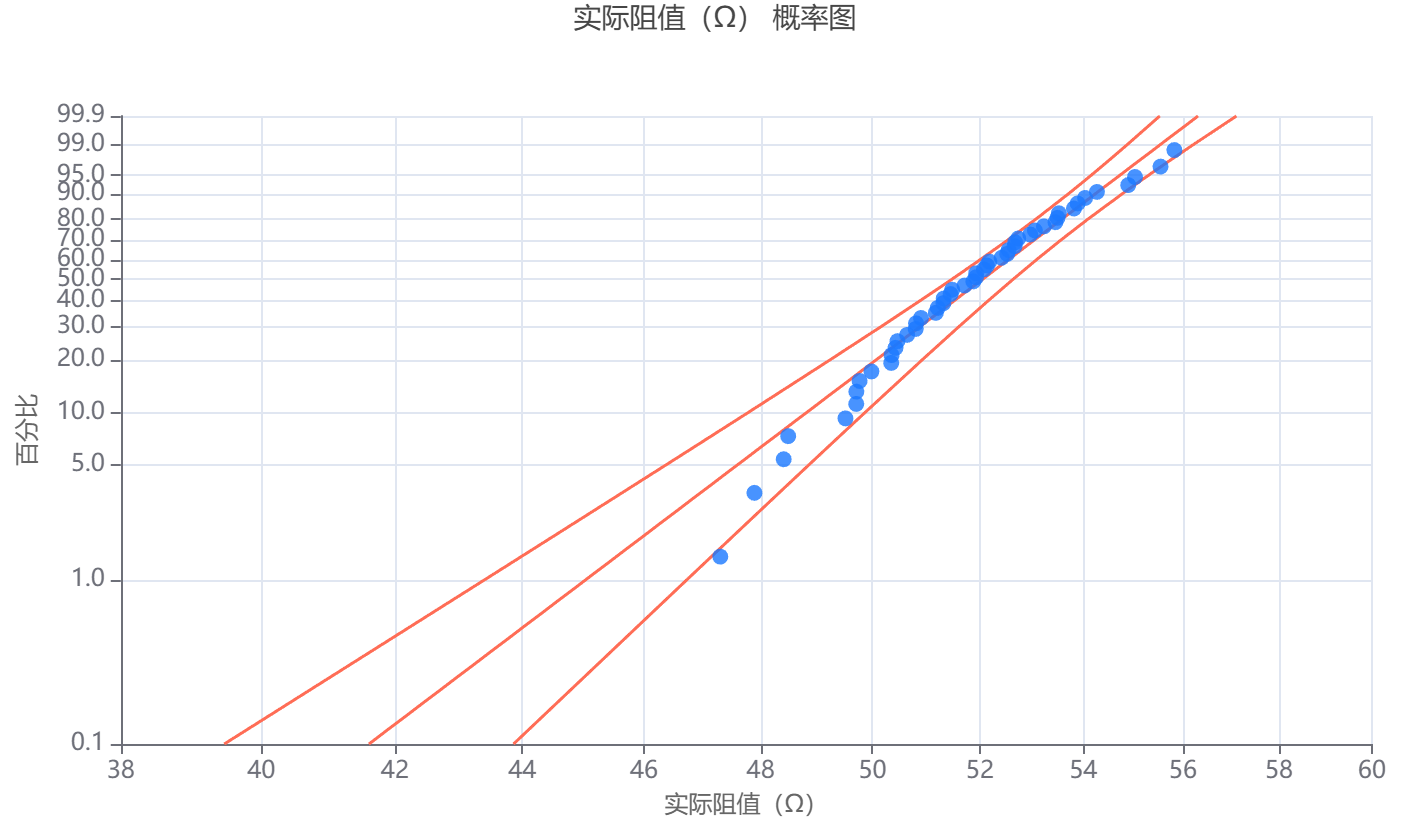
图表说明:上图展示了直方图和概率分布图。用于探索数据是否符合指定分布,若是不符合指定分布,那么该分布计算出来的公差区间不可用,需要切换分布或者使用非参数的公差区间作为结论。
# 7、注意事项
公差区间算法的核心注意事项是先匹配分布前提、再把控参数设定、最后结合业务校验区间合理性,若忽视任一环节,会导致区间失去统计意义或无法落地。
# 8、模型理论
公差区间是用于估计 “总体中一定比例的个体(如产品性能、实验结果)会落在某个数值范围内” 的统计区间,核心价值是为产品质量控制、实验结果可靠性验证提供 “区间保证。
(1)参数法
假设总体数据服从特定分布(如正态分布),基于分布参数(均值、标准差)计算公差区间;
(1.1)双侧公差区间
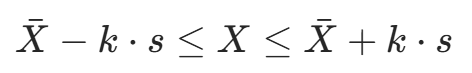
k= 公差因子(由样本量n、覆盖比例p、置信水平γ确定)

其中:(α=1-γ)(置信水平互补值),(α2=1-p)(覆盖比例互补值),(F_{1-α,2,n-1})为 F 分布分位数,(t_{1-α2/2,n-1})为 t 分布双侧分位数
(1.2)单侧公差区间
下限(至少p比例个体≥该值):
上限(至少p比例个体≤该值):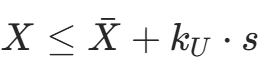
说明:(k_L)(单侧下限因子)、(k_U)(单侧上限因子)与双侧k取值不同,软件自动匹配
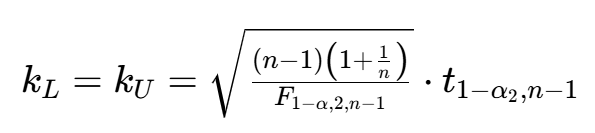
其中,t 分布是单侧分位数(t_{1-α2,n-1})
(2)非参数法
不假设总体分布类型,直接基于样本数据的排序统计量计算公差区间;
(2.1)双侧公差区间
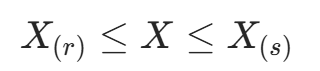
(2.2)单侧公差区间
下限:
上限:
说明:r、s为数据排序后的位置,计算方式如下
- 第一步:计算需要覆盖的样本数量 = 总样本量 n × 覆盖比例 p(向上取整);
- 第二步:从排序后的样本两端去掉少量极端值,直到剩余样本数量 ≥ 第一步计算的数量,且这种去掉方式的可靠程度(置信水平)≥ γ;
- 第三步:剩余样本的第一个位置就是 r,最后一个位置就是 s
# 9、参考文献
[1]Scientific Platform Serving for Statistics Professional 2021. SPSSPRO. (Version 1.0.11)[Online Application Software]. Retrieved from https://www.spsspro.com.